最新动态 · 按时间排列60
10月28日33
AI眼镜BrilliantHalo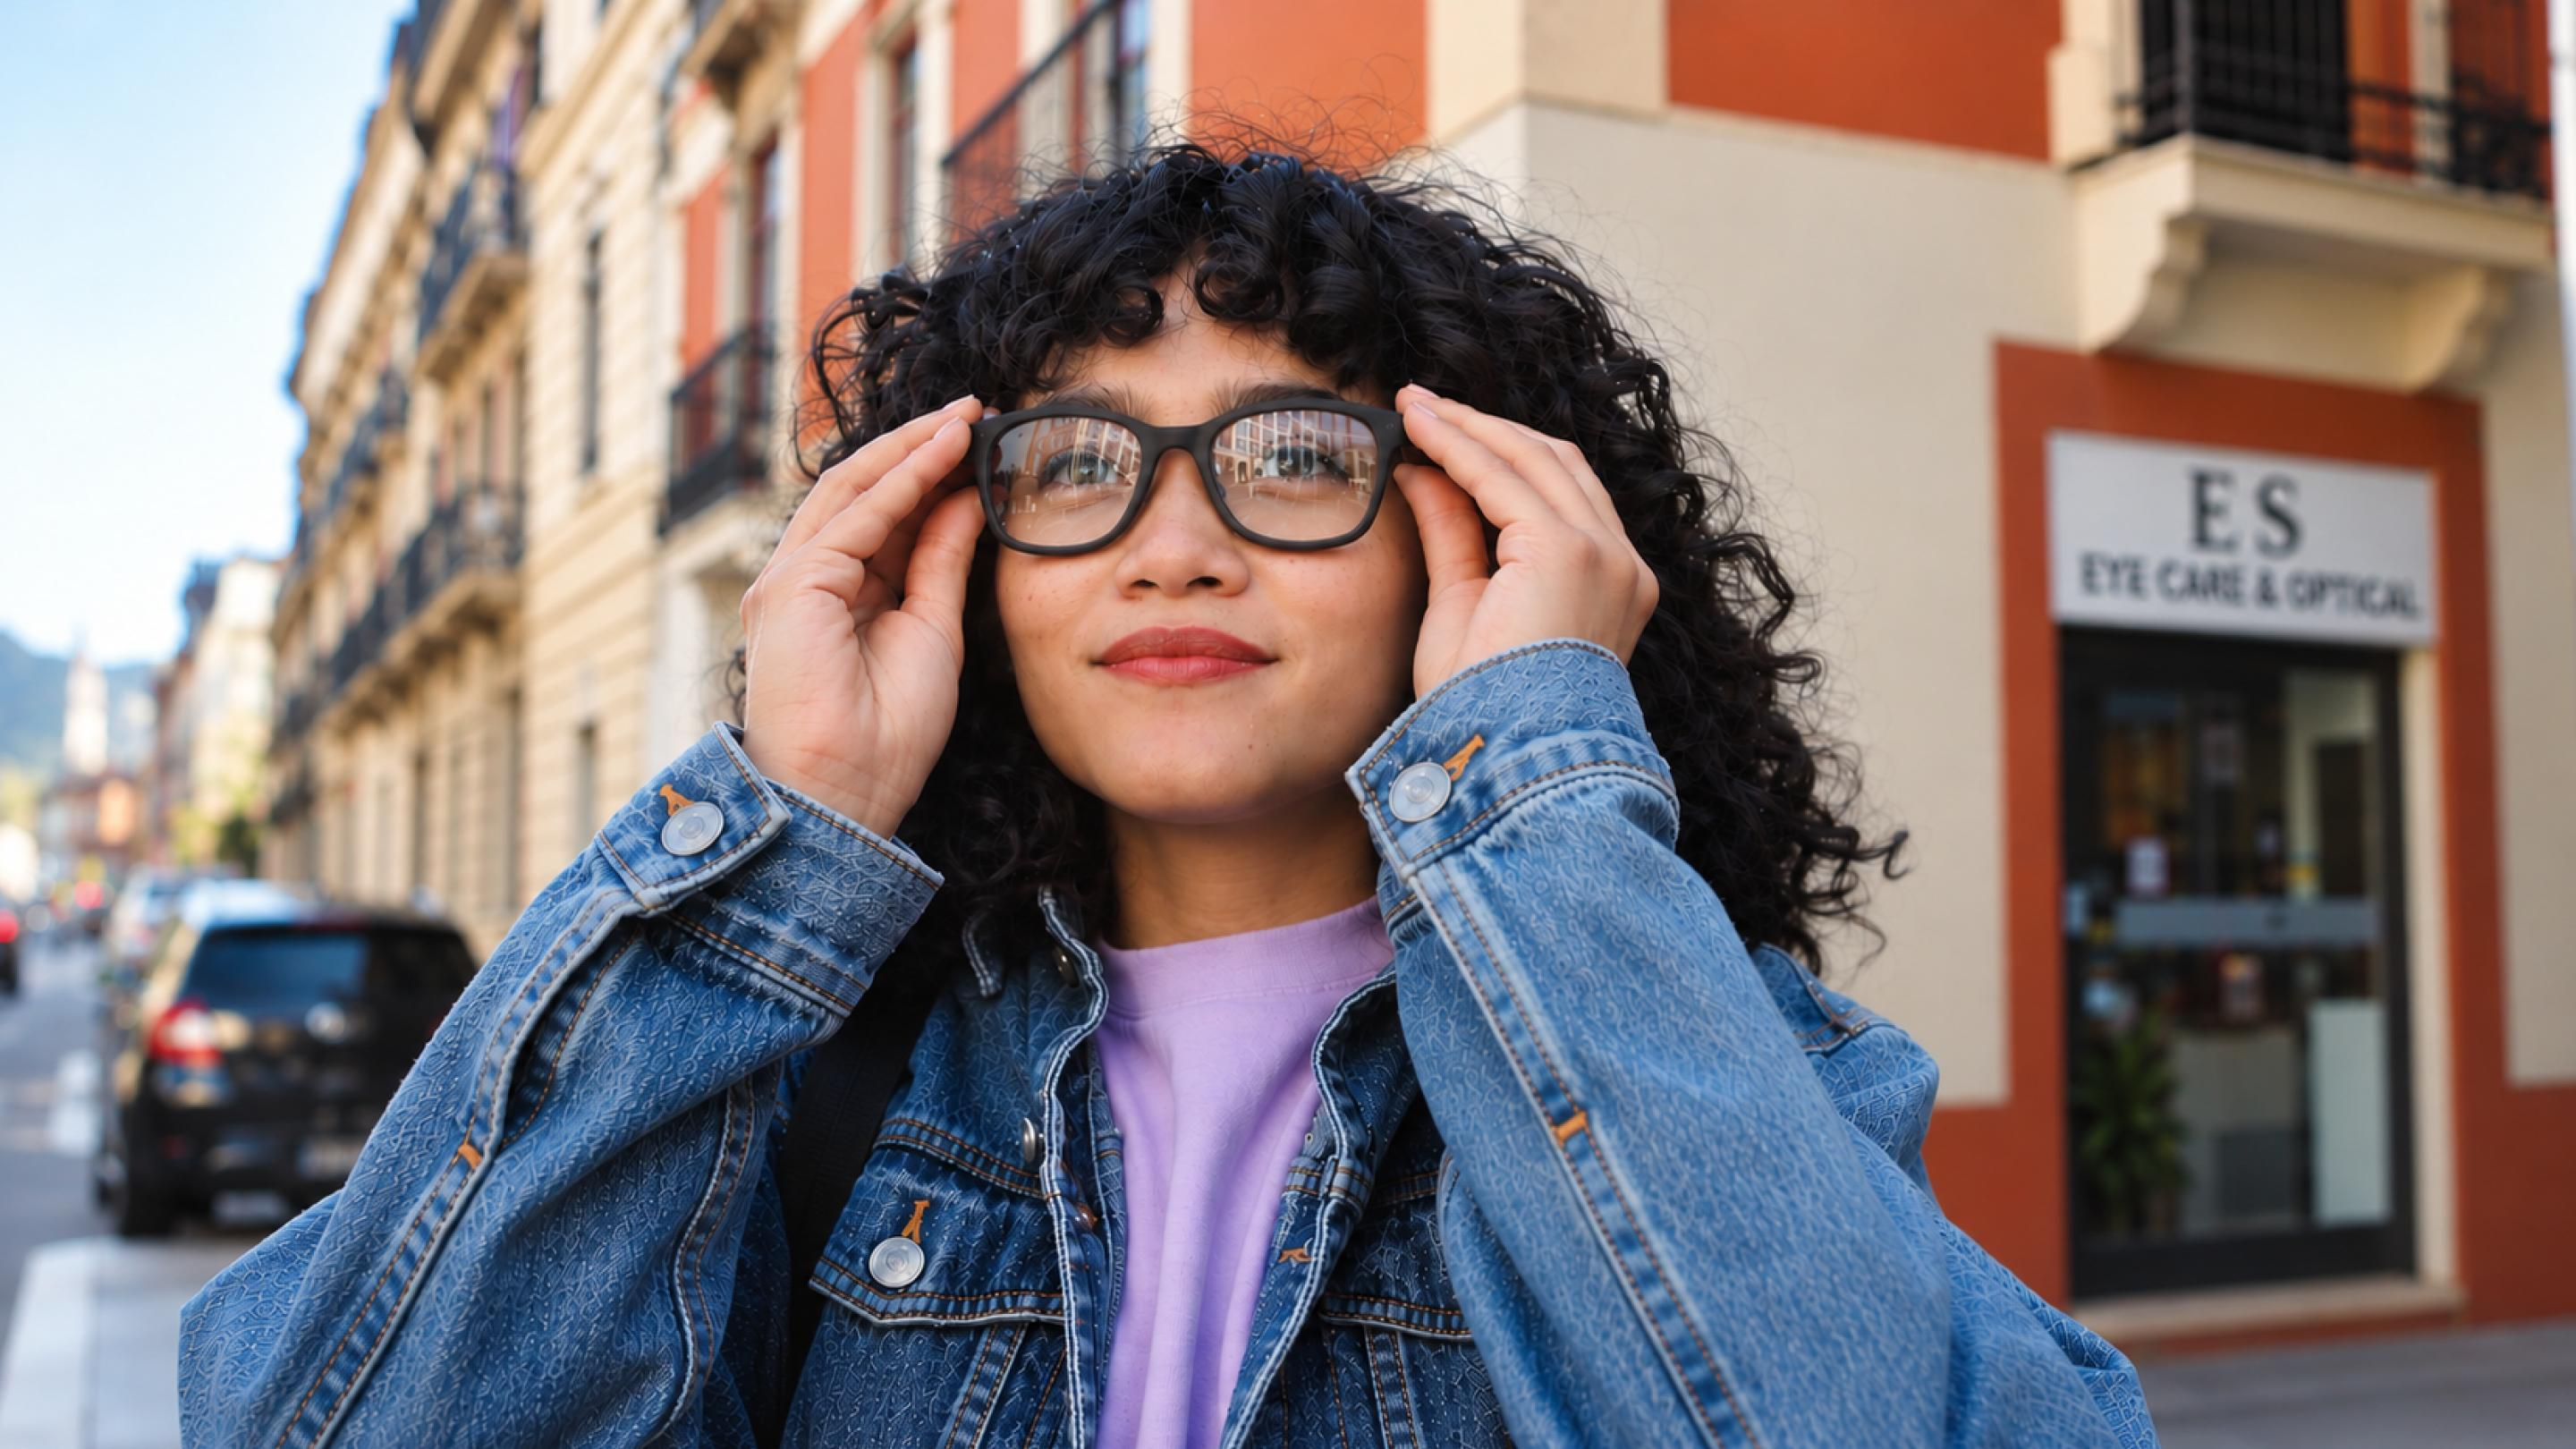 全彩Micro-OLED、端侧AI、开源架构,Brilliant Labs发布Halo AI眼镜编译/VR陀螺 当地时间10月27日,总部位于新加坡的智能眼镜厂商Brilliant Labs正式发布新一代Halo AI眼镜,售价399美元。新品采用全彩Micro-OLED显示屏,集成长期记忆AI助手,并引入名为Narrative的自适应游戏体验,主打开放源代码架构、端侧AI处理及隐私保护。 据了解,Halo搭载Brilliant Labs自研AI助手N…全彩Micro-OLED、端侧AI、开源架构,Brilliant Labs发布Halo AI眼镜编译/VR陀螺 当地时间10月27日,总部位于新加坡的智能眼镜厂商Brilliant Labs正式发布新一代Halo AI眼镜,售价399美元。新品采用全彩Micro-OLED显示屏,集成长期记忆AI助手,并引入名为Narrative的自适应游戏体验,主打开放源代码架构、端侧AI处理及隐私保护。 据了解,Halo搭载Brilliant Labs自研AI助手N…AI眼镜BrilliantHalo阅读全文 ↗
Clover-35B-A3B-PreviewFaceHugging Diffuspace/Clover-35B-A3B-Preview · Hugging Face 模型仓库Reddit 用户 jacek2023 分享:DiffuSpace 发布其首个模型 Clover-35B-A3B-Preview,据发布博客公布的基准测试,发布时在开源扩散语言模型中达到最先进水平。Clover 采用 35B 参数混合专家(MoE)骨干、每个 token 仅约 3B 激活参数,使用块扩散(block diffusion)生成,支持 128K 上下文窗口;相关链接(发布博客、代码与推理后端、Hugging Face)见原帖。Diffuspace/Clover-35B-A3B-Preview · Hugging Face 模型仓库Reddit 用户 jacek2023 分享:DiffuSpace 发布其首个模型 Clover-35B-A3B-Preview,据发布博客公布的基准测试,发布时在开源扩散语言模型中达到最先进水平。Clover 采用 35B 参数混合专家(MoE)骨干、每个 token 仅约 3B 激活参数,使用块扩散(block diffusion)生成,支持 128K 上下文窗口;相关链接(发布博客、代码与推理后端、Hugging Face)见原帖。Clover-35B-A3B-PreviewFaceHugging阅读全文 ↗
b11951llama.cppchat llama.cpp b11951chat:在模板分隔符之前截断 qwen3-coder 的推理过程与生成内容……(议题标题,原文在此截断)llama.cpp b11951chat:在模板分隔符之前截断 qwen3-coder 的推理过程与生成内容……(议题标题,原文在此截断)b11951llama.cppchat阅读全文 ↗
Q-learning一页纸笔记发布 从零学习强化学习:发布 Q-learning 一页纸笔记楼主在自学强化学习的过程中,发布了关于 Q-learning 的一页纸精简笔记:内容短小而连贯,附带代码片段与必要的数学推导及解释,并邀请读者访问网站查看、分享反馈。从零学习强化学习:发布 Q-learning 一页纸笔记楼主在自学强化学习的过程中,发布了关于 Q-learning 的一页纸精简笔记:内容短小而连贯,附带代码片段与必要的数学推导及解释,并邀请读者访问网站查看、分享反馈。Q-learning一页纸笔记发布阅读全文 ↗
one-shot效果编程模型 4B 3D 编程模型更新:one-shot 效果与视觉质量大幅提升作者上传了其 4B 编程模型的新版本:最新测试中 one-shot 结果与视觉质量都明显更好,训练已接近完成。推荐从 Q8 起步(作者实测版本,参数 temperature 0.6、top-k 20、top-p 0.95);Q4 也可用但尚未实测。虽然本轮训练未包含视觉编码器,用图像参考生成 3D 场景的效果也不错;数据集与完整 FP16 权重承诺今日发布。4B 3D 编程模型更新:one-shot 效果与视觉质量大幅提升作者上传了其 4B 编程模型的新版本:最新测试中 one-shot 结果与视觉质量都明显更好,训练已接近完成。推荐从 Q8 起步(作者实测版本,参数 temperature 0.6、top-k 20、top-p 0.95);Q4 也可用但尚未实测。虽然本轮训练未包含视觉编码器,用图像参考生成 3D 场景的效果也不错;数据集与完整 FP16 权重承诺今日发布。one-shot效果编程模型阅读全文 ↗
明年或将迎来白菜价Anthropic明年或将迎来「白菜价」GPU发帖人认为,多方迹象指向未来数月 GPU 价格大概率崩盘:一组 GB300 机柜即可承接 OpenRouter 全部 DSV4.1 Flash 流量;数据中心建设已有约半数被取消或搁置;Neocloud 厂商难以为算力债务融资,还被锁在没有确认需求的五年长约里;AI 采用率不及预期,更小的模型已能承接多数请求;OpenAI/Anthropic 恐难为接下来的算力合同融资。作者据此判断,明年会出现大量廉价 GPU。明年或将迎来「白菜价」GPU发帖人认为,多方迹象指向未来数月 GPU 价格大概率崩盘:一组 GB300 机柜即可承接 OpenRouter 全部 DSV4.1 Flash 流量;数据中心建设已有约半数被取消或搁置;Neocloud 厂商难以为算力债务融资,还被锁在没有确认需求的五年长约里;AI 采用率不及预期,更小的模型已能承接多数请求;OpenAI/Anthropic 恐难为接下来的算力合同融资。作者据此判断,明年会出现大量廉价 GPU。明年或将迎来白菜价Anthropic阅读全文 ↗
MoESparktok 在 NVIDIA DGX Spark 上提升 MoE 推理的三种方法帖子实测了在 NVIDIA DGX Spark 上提升 MoE 推理的三项优化:Humming MXFP4 MoE 后端、在线 FP8 LM head 量化、以及基于 NEXTN 的 MTP 投机解码。逐项叠加后:基线 TPOT 27.71 ms、解码吞吐 36.09 tok/s;+Humming MoE 后端为 25.35 ms / 39.45 tok/s(+9.3%);再+在线 FP8 LM head 为 22.76 ms / 43.94 tok/s(+21.7%);再+MTP(NEXTN,steps=3 / topk=1 / draft_tokens=4)达 9.72 ms / 102.88 tok/s(+185.1%)。在 NVIDIA DGX Spark 上提升 MoE 推理的三种方法帖子实测了在 NVIDIA DGX Spark 上提升 MoE 推理的三项优化:Humming MXFP4 MoE 后端、在线 FP8 LM head 量化、以及基于 NEXTN 的 MTP 投机解码。逐项叠加后:基线 TPOT 27.71 ms、解码吞吐 36.09 tok/s;+Humming MoE 后端为 25.35 ms / 39.45 tok/s(+9.3%);再+在线 FP8 LM head 为 22.76 ms / 43.94 tok/s(+21.7%);再+MTP(NEXTN,steps=3 / topk=1 / draft_tokens=4)达 9.72 ms / 102.88 tok/s(+185.1%)。MoESparktok阅读全文 ↗
AnalysisArtificialIndex Artificial Analysis Intelligence Index v5(重大更新)讨论 Artificial Analysis Intelligence Index 更新至 v5:官方称这是一次让排名更准确的大版本升级,并明显拉开了开放权重模型与闭源模型的差距。已有人基于自身用模体验质疑其准确性(GPT-Terra-6.1 > Fable-5.1)。此外 v5 中 60% 的指数分数来自使用私有测试集或保留答案的评测,结果无法复现。官方公告称:「开放权重阵营的差距从 3 分扩大到 12 分:Kimi K3.1 Pro(权重尚未发布)以 46 分位居开放权重模型之首;在已发布权重中,DeepSeek V4.1 Flash 1017 (max) 与 GLM-5.3 (max) 以 32 分领跑——落后榜首 26 分,低于 Claude Haiku 5.5 (max, 36)」。Artificial Analysis Intelligence Index v5(重大更新)讨论 Artificial Analysis Intelligence Index 更新至 v5:官方称这是一次让排名更准确的大版本升级,并明显拉开了开放权重模型与闭源模型的差距。已有人基于自身用模体验质疑其准确性(GPT-Terra-6.1 > Fable-5.1)。此外 v5 中 60% 的指数分数来自使用私有测试集或保留答案的评测,结果无法复现。官方公告称:「开放权重阵营的差距从 3 分扩大到 12 分:Kimi K3.1 Pro(权重尚未发布)以 46 分位居开放权重模型之首;在已发布权重中,DeepSeek V4.1 Flash 1017 (max) 与 GLM-5.3 (max) 以 32 分领跑——落后榜首 26 分,低于 Claude Haiku 5.5 (max, 36)」。AnalysisArtificialIndex阅读全文 ↗
Google何时才大众Google 的 TPU 何时才会惠及普通大众?讨论帖问:Google TPU 什么时候才能落到普通人手里?眼下各大主要玩家都在采购 TPU——OpenAI 计划向 Google 购买 AI 芯片,Oracle 也将通过其云提供 TPU,那我们本地用上的日子还会远吗?Google 的 TPU 何时才会惠及普通大众?讨论帖问:Google TPU 什么时候才能落到普通人手里?眼下各大主要玩家都在采购 TPU——OpenAI 计划向 Google 购买 AI 芯片,Oracle 也将通过其云提供 TPU,那我们本地用上的日子还会远吗?Google何时才大众阅读全文 ↗
datalab-toindratesseract tesseract 的后继者发布了(datalab-to/indra)帖主还没试用,但 tesseract 的水平众所周知,基准测试显示新模型 datalab-to/indra 在质量与速度上都有漂亮的跃升——而它只有 100 万(1M)参数。帖主感慨本以为看不到这一天,如今小于 1B 参数的模型正层出不穷(GitHub:https://github.com/datalab-to/indra)。tesseract 的后继者发布了(datalab-to/indra)帖主还没试用,但 tesseract 的水平众所周知,基准测试显示新模型 datalab-to/indra 在质量与速度上都有漂亮的跃升——而它只有 100 万(1M)参数。帖主感慨本以为看不到这一天,如今小于 1B 参数的模型正层出不穷(GitHub:https://github.com/datalab-to/indra)。datalab-toindratesseract阅读全文 ↗
x64UbuntuWindows llama.cpp server:在 /v1/realtime 上新增实时对话与转写(#31269)server:在 /v1/realtime 上新增实时对话与转写(#31269)
server:在 /v1/realtime 上新增实时对话与转写
Co-authored-by: Xuan Son Nguyen son@huggingface.co
Assisted-by: Claude Opus 5.5
examples:realtime 客户端默认指向服务器端口 9931
Assisted-by: Claude Opus 5.5
server:各实时响应在自己的解码完成后立即采样
多个 slot 共用一个 context 轮流应答:此前在下一步开始时才采样,读到的是最后完成解码的那个 slot 的 logits,并发会话的输出因此相互混杂。
Assisted-by: Claude Opus 5.5
将更多代码迁入 server-realtime,使其自包含
examples:修复 realtime 客户端的类型检查
Assisted-by: Claude Opus 5.5
examples:realtime 客户端改用模型卡中的提示词
Assisted-by: Claude Opus 5.5
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60644875
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp server:在 /v1/realtime 上新增实时对话与转写(#31269)server:在 /v1/realtime 上新增实时对话与转写(#31269)
server:在 /v1/realtime 上新增实时对话与转写
Co-authored-by: Xuan Son Nguyen son@huggingface.co
Assisted-by: Claude Opus 5.5
examples:realtime 客户端默认指向服务器端口 9931
Assisted-by: Claude Opus 5.5
server:各实时响应在自己的解码完成后立即采样
多个 slot 共用一个 context 轮流应答:此前在下一步开始时才采样,读到的是最后完成解码的那个 slot 的 logits,并发会话的输出因此相互混杂。
Assisted-by: Claude Opus 5.5
将更多代码迁入 server-realtime,使其自包含
examples:修复 realtime 客户端的类型检查
Assisted-by: Claude Opus 5.5
examples:realtime 客户端改用模型卡中的提示词
Assisted-by: Claude Opus 5.5
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60644875
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗
llama.cpp server:在 /v1/realtime 上新增实时对话与转写(#31269)server:在 /v1/realtime 上新增实时对话与转写(#31269)
server:在 /v1/realtime 上新增实时对话与转写
Co-authored-by: Xuan Son Nguyen son@huggingface.co
Assisted-by: Claude Opus 5.5
examples:realtime 客户端默认指向服务器端口 9931
Assisted-by: Claude Opus 5.5
server:各实时响应在自己的解码完成后立即采样
多个 slot 共用一个 context 轮流应答:此前在下一步开始时才采样,读到的是最后完成解码的那个 slot 的 logits,并发会话的输出因此相互混杂。
Assisted-by: Claude Opus 5.5
将更多代码迁入 server-realtime,使其自包含
examples:修复 realtime 客户端的类型检查
Assisted-by: Claude Opus 5.5
examples:realtime 客户端改用模型卡中的提示词
Assisted-by: Claude Opus 5.5
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60644875
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp server:在 /v1/realtime 上新增实时对话与转写(#31269)server:在 /v1/realtime 上新增实时对话与转写(#31269)
server:在 /v1/realtime 上新增实时对话与转写
Co-authored-by: Xuan Son Nguyen son@huggingface.co
Assisted-by: Claude Opus 5.5
examples:realtime 客户端默认指向服务器端口 9931
Assisted-by: Claude Opus 5.5
server:各实时响应在自己的解码完成后立即采样
多个 slot 共用一个 context 轮流应答:此前在下一步开始时才采样,读到的是最后完成解码的那个 slot 的 logits,并发会话的输出因此相互混杂。
Assisted-by: Claude Opus 5.5
将更多代码迁入 server-realtime,使其自包含
examples:修复 realtime 客户端的类型检查
Assisted-by: Claude Opus 5.5
examples:realtime 客户端改用模型卡中的提示词
Assisted-by: Claude Opus 5.5
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60644875
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗x64UbuntuWindowsllama.cpp:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B 模型(#31275)model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B(#31275)
model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B
Assisted-by: Claude Opus 5.5
convert:将语音任务模板排除在 d1 的 GGUF 之外
Assisted-by: Claude Opus 5.5
小型重构:no_batching
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60641357
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B 模型(#31275)model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B(#31275)
model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B
Assisted-by: Claude Opus 5.5
convert:将语音任务模板排除在 d1 的 GGUF 之外
Assisted-by: Claude Opus 5.5
小型重构:no_batching
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60641357
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗
llama.cpp:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B 模型(#31275)model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B(#31275)
model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B
Assisted-by: Claude Opus 5.5
convert:将语音任务模板排除在 d1 的 GGUF 之外
Assisted-by: Claude Opus 5.5
小型重构:no_batching
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60641357
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B 模型(#31275)model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B(#31275)
model:新增 LiquidAI/d1-2B 与 LiquidAI/d1-omni-2B
Assisted-by: Claude Opus 5.5
convert:将语音任务模板排除在 d1 的 GGUF 之外
Assisted-by: Claude Opus 5.5
小型重构:no_batching
Co-authored-by: Xuan Son Nguyen son@huggingface.co
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60641357
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗x64UbuntuWindowsllama.cpp server:暴露 chat template 的推理努力程度档位(#31271)server:暴露 chat template 的推理努力程度档位(#31271)
server:暴露 chat template 的推理努力程度档位
能力探测(capability probe)会为每个候选档位(minimal、low、medium、high、xhigh、max)以及一个未知档位各渲染一条用户消息(user turn)。
只要某档位渲染时不报错、且渲染结果不同于未知档位(未知档位展示的是模板的回退行为),该档位即被视为受支持。
渲染结果相同的档位互为别名,只保留其中最高的一档。
这些能力信息(caps)会序列化为 JSON;/props 中的 chat_template_caps 以 reasoning_effort_levels 字段上报该列表,按从低到高排序。
jinja:让 caps 摆脱对 json 的依赖
caps 仍以 map 形式上报各自的标志位,努力程度档位则保持为普通成员。
服务器上报的 JSON 由 common_chat_templates_get_caps() 从两者构建,因此 jinja 仅在探测输入上依赖 json。
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60638014
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp server:暴露 chat template 的推理努力程度档位(#31271)server:暴露 chat template 的推理努力程度档位(#31271)
server:暴露 chat template 的推理努力程度档位
能力探测(capability probe)会为每个候选档位(minimal、low、medium、high、xhigh、max)以及一个未知档位各渲染一条用户消息(user turn)。
只要某档位渲染时不报错、且渲染结果不同于未知档位(未知档位展示的是模板的回退行为),该档位即被视为受支持。
渲染结果相同的档位互为别名,只保留其中最高的一档。
这些能力信息(caps)会序列化为 JSON;/props 中的 chat_template_caps 以 reasoning_effort_levels 字段上报该列表,按从低到高排序。
jinja:让 caps 摆脱对 json 的依赖
caps 仍以 map 形式上报各自的标志位,努力程度档位则保持为普通成员。
服务器上报的 JSON 由 common_chat_templates_get_caps() 从两者构建,因此 jinja 仅在探测输入上依赖 json。
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60638014
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗
llama.cpp server:暴露 chat template 的推理努力程度档位(#31271)server:暴露 chat template 的推理努力程度档位(#31271)
server:暴露 chat template 的推理努力程度档位
能力探测(capability probe)会为每个候选档位(minimal、low、medium、high、xhigh、max)以及一个未知档位各渲染一条用户消息(user turn)。
只要某档位渲染时不报错、且渲染结果不同于未知档位(未知档位展示的是模板的回退行为),该档位即被视为受支持。
渲染结果相同的档位互为别名,只保留其中最高的一档。
这些能力信息(caps)会序列化为 JSON;/props 中的 chat_template_caps 以 reasoning_effort_levels 字段上报该列表,按从低到高排序。
jinja:让 caps 摆脱对 json 的依赖
caps 仍以 map 形式上报各自的标志位,努力程度档位则保持为普通成员。
服务器上报的 JSON 由 common_chat_templates_get_caps() 从两者构建,因此 jinja 仅在探测输入上依赖 json。
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60638014
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)llama.cpp server:暴露 chat template 的推理努力程度档位(#31271)server:暴露 chat template 的推理努力程度档位(#31271)
server:暴露 chat template 的推理努力程度档位
能力探测(capability probe)会为每个候选档位(minimal、low、medium、high、xhigh、max)以及一个未知档位各渲染一条用户消息(user turn)。
只要某档位渲染时不报错、且渲染结果不同于未知档位(未知档位展示的是模板的回退行为),该档位即被视为受支持。
渲染结果相同的档位互为别名,只保留其中最高的一档。
这些能力信息(caps)会序列化为 JSON;/props 中的 chat_template_caps 以 reasoning_effort_levels 字段上报该列表,按从低到高排序。
jinja:让 caps 摆脱对 json 的依赖
caps 仍以 map 形式上报各自的标志位,努力程度档位则保持为普通成员。
服务器上报的 JSON 由 common_chat_templates_get_caps() 从两者构建,因此 jinja 仅在探测输入上依赖 json。
官网:https://llama.app
Attestations:https://github.com/ggml-org/llama.cpp/attestations/60638014
macOS/iOS:
- macOS Apple Silicon(arm64)
- macOS Apple Silicon(arm64,启用 KleidiAI)
- DISABLED
- macOS Intel(x64)
- iOS XCFramework
Linux:
- Ubuntu x64(CPU)
- Ubuntu arm64(CPU)
- Ubuntu s390x(CPU)
- Ubuntu x64(Vulkan)
- Ubuntu arm64(Vulkan)
- Ubuntu x64(CUDA 12,含 CUDA 12.8 运行库)
- Ubuntu x64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu arm64(CUDA 13,含 CUDA 13.4 运行库)
- Ubuntu x64(ROCm 10.0)
- Ubuntu x64(OpenVINO)
- Ubuntu x64(SYCL FP32)
- Ubuntu x64(SYCL FP16)
- Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Android:
- Android arm64(CPU)
- Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU,附设置指南)
Windows:
- Windows x64(CPU)
- Windows arm64(CPU)
- Windows arm64(OpenCL Adreno)
- Windows x64(CUDA 12,含 CUDA 12.4 DLL)
- Windows x64(CUDA 13,含 CUDA 13.4 DLL)
- Windows arm64(CUDA 13,含 CUDA 13.4 DLL)
- Windows x64(Vulkan)
- Windows arm64(Vulkan)
- Windows x64(OpenVINO)
- Windows x64(SYCL)
- Windows x64(ROCm 10.0)
openEuler:DISABLED
- openEuler x86(310p)
- openEuler x86(910b,ACL Graph)
- openEuler aarch64(310p)
- openEuler aarch64(910b,ACL Graph)
UI:UI(原文至此截断)x64UbuntuWindows阅读全文 ↗x64UbuntuWindowsllama.cpp b11941:新增 LiquidAI/LFM3-Audio-2B 与 LFM3-Omni-2B 模型支持model:新增 LiquidAI/LFM3-Audio-2B 与 LiquidAI/LFM3-Omni-2B(#31257)
Co-authored-by: Xuan Son Nguyen(son@huggingface.co);Assisted-by: Claude Opus 5.5
convert:按发布时的原始形态读取 LFM3-Audio 的 config.json——识别 lfm3_audio 的 transformers 会把 config 重写成另一种布局(不再有 lfm/encoder 键)。Assisted-by: Claude Opus 5.5
mtmd:为 LFM3-Audio 的 depthformer 关闭 flash attention。Assisted-by: Claude Opus 5.5
tts:为 LFM3-Audio 与 LFM3-Omni 增加音色选项——模型卡提供女声和男声两种音色;llama-tts 用 --tts-voice,server 的 /tts 接口用 "voice"。Assisted-by: Claude Opus 5.5
清理模板处理:convert 按 model_type 检测 LFM3-Audio 与 LFM3-Omni(Assisted-by: Claude Opus 5.5);banned tokens 移入 logits bias 并归入 mtmd_helper,mtmd-cli 保持不变,不再残留 template_asr_system。
llama:保持 LFM3-Audio 的编码器卷积与 codec 不做量化。Assisted-by: Claude Opus 5.5
common、mtmd:精简注释。Assisted-by: Claude Opus 5.5;Co-authored-by: Xuan Son Nguyen(son@huggingface.co)
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60633440
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIllama.cpp b11941:新增 LiquidAI/LFM3-Audio-2B 与 LFM3-Omni-2B 模型支持model:新增 LiquidAI/LFM3-Audio-2B 与 LiquidAI/LFM3-Omni-2B(#31257)
Co-authored-by: Xuan Son Nguyen(son@huggingface.co);Assisted-by: Claude Opus 5.5
convert:按发布时的原始形态读取 LFM3-Audio 的 config.json——识别 lfm3_audio 的 transformers 会把 config 重写成另一种布局(不再有 lfm/encoder 键)。Assisted-by: Claude Opus 5.5
mtmd:为 LFM3-Audio 的 depthformer 关闭 flash attention。Assisted-by: Claude Opus 5.5
tts:为 LFM3-Audio 与 LFM3-Omni 增加音色选项——模型卡提供女声和男声两种音色;llama-tts 用 --tts-voice,server 的 /tts 接口用 "voice"。Assisted-by: Claude Opus 5.5
清理模板处理:convert 按 model_type 检测 LFM3-Audio 与 LFM3-Omni(Assisted-by: Claude Opus 5.5);banned tokens 移入 logits bias 并归入 mtmd_helper,mtmd-cli 保持不变,不再残留 template_asr_system。
llama:保持 LFM3-Audio 的编码器卷积与 codec 不做量化。Assisted-by: Claude Opus 5.5
common、mtmd:精简注释。Assisted-by: Claude Opus 5.5;Co-authored-by: Xuan Son Nguyen(son@huggingface.co)
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60633440
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIx64UbuntuWindows阅读全文 ↗
llama.cpp b11941:新增 LiquidAI/LFM3-Audio-2B 与 LFM3-Omni-2B 模型支持model:新增 LiquidAI/LFM3-Audio-2B 与 LiquidAI/LFM3-Omni-2B(#31257)
Co-authored-by: Xuan Son Nguyen(son@huggingface.co);Assisted-by: Claude Opus 5.5
convert:按发布时的原始形态读取 LFM3-Audio 的 config.json——识别 lfm3_audio 的 transformers 会把 config 重写成另一种布局(不再有 lfm/encoder 键)。Assisted-by: Claude Opus 5.5
mtmd:为 LFM3-Audio 的 depthformer 关闭 flash attention。Assisted-by: Claude Opus 5.5
tts:为 LFM3-Audio 与 LFM3-Omni 增加音色选项——模型卡提供女声和男声两种音色;llama-tts 用 --tts-voice,server 的 /tts 接口用 "voice"。Assisted-by: Claude Opus 5.5
清理模板处理:convert 按 model_type 检测 LFM3-Audio 与 LFM3-Omni(Assisted-by: Claude Opus 5.5);banned tokens 移入 logits bias 并归入 mtmd_helper,mtmd-cli 保持不变,不再残留 template_asr_system。
llama:保持 LFM3-Audio 的编码器卷积与 codec 不做量化。Assisted-by: Claude Opus 5.5
common、mtmd:精简注释。Assisted-by: Claude Opus 5.5;Co-authored-by: Xuan Son Nguyen(son@huggingface.co)
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60633440
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIllama.cpp b11941:新增 LiquidAI/LFM3-Audio-2B 与 LFM3-Omni-2B 模型支持model:新增 LiquidAI/LFM3-Audio-2B 与 LiquidAI/LFM3-Omni-2B(#31257)
Co-authored-by: Xuan Son Nguyen(son@huggingface.co);Assisted-by: Claude Opus 5.5
convert:按发布时的原始形态读取 LFM3-Audio 的 config.json——识别 lfm3_audio 的 transformers 会把 config 重写成另一种布局(不再有 lfm/encoder 键)。Assisted-by: Claude Opus 5.5
mtmd:为 LFM3-Audio 的 depthformer 关闭 flash attention。Assisted-by: Claude Opus 5.5
tts:为 LFM3-Audio 与 LFM3-Omni 增加音色选项——模型卡提供女声和男声两种音色;llama-tts 用 --tts-voice,server 的 /tts 接口用 "voice"。Assisted-by: Claude Opus 5.5
清理模板处理:convert 按 model_type 检测 LFM3-Audio 与 LFM3-Omni(Assisted-by: Claude Opus 5.5);banned tokens 移入 logits bias 并归入 mtmd_helper,mtmd-cli 保持不变,不再残留 template_asr_system。
llama:保持 LFM3-Audio 的编码器卷积与 codec 不做量化。Assisted-by: Claude Opus 5.5
common、mtmd:精简注释。Assisted-by: Claude Opus 5.5;Co-authored-by: Xuan Son Nguyen(son@huggingface.co)
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60633440
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIx64UbuntuWindows阅读全文 ↗DeepSeek-V4.1-Flash-1017tok单张 单张 3090 跑 DeepSeek-V4.1-Flash-1017 达 41 tok/s不,这不是被阉割的 1-bit 极限压缩,而是 nazeshinjite 的 DeepSeek-V4.1-Flash-1017 完整 Q2 GGUF,跑在单张 3090 上,原生 Windows、无需 WSL。在配 192 GB 内存的 RTX 3090 上,我以 41 tok/s 的速度写作(多个提示词的平均值),输出在下一个 token 上与 DeepSeek 官方 API 的一致率达 90.2%单张 3090 跑 DeepSeek-V4.1-Flash-1017 达 41 tok/s不,这不是被阉割的 1-bit 极限压缩,而是 nazeshinjite 的 DeepSeek-V4.1-Flash-1017 完整 Q2 GGUF,跑在单张 3090 上,原生 Windows、无需 WSL。在配 192 GB 内存的 RTX 3090 上,我以 41 tok/s 的速度写作(多个提示词的平均值),输出在下一个 token 上与 DeepSeek 官方 API 的一致率达 90.2%DeepSeek-V4.1-Flash-1017tok单张阅读全文 ↗
x64UbuntuWindowsllama.cpp b11940:支持 deferred tools 与 tool_reference 内容部件common:支持 deferred tools(延迟工具)与 tool_reference 内容部件(#31256)
Assisted-by: Claude Opus 5.5
common:为 deferred tools 的共同作者署名。Co-authored-by: Aldehir Rojas(765227+aldehir@users.noreply.github.com);Assisted-by: Claude Opus 5.5
tests:修复 deferred tools 测试的类型检查。Assisted-by: Claude Opus 5.5
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60626465
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIllama.cpp b11940:支持 deferred tools 与 tool_reference 内容部件common:支持 deferred tools(延迟工具)与 tool_reference 内容部件(#31256)
Assisted-by: Claude Opus 5.5
common:为 deferred tools 的共同作者署名。Co-authored-by: Aldehir Rojas(765227+aldehir@users.noreply.github.com);Assisted-by: Claude Opus 5.5
tests:修复 deferred tools 测试的类型检查。Assisted-by: Claude Opus 5.5
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60626465
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIx64UbuntuWindows阅读全文 ↗
llama.cpp b11940:支持 deferred tools 与 tool_reference 内容部件common:支持 deferred tools(延迟工具)与 tool_reference 内容部件(#31256)
Assisted-by: Claude Opus 5.5
common:为 deferred tools 的共同作者署名。Co-authored-by: Aldehir Rojas(765227+aldehir@users.noreply.github.com);Assisted-by: Claude Opus 5.5
tests:修复 deferred tools 测试的类型检查。Assisted-by: Claude Opus 5.5
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60626465
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIllama.cpp b11940:支持 deferred tools 与 tool_reference 内容部件common:支持 deferred tools(延迟工具)与 tool_reference 内容部件(#31256)
Assisted-by: Claude Opus 5.5
common:为 deferred tools 的共同作者署名。Co-authored-by: Aldehir Rojas(765227+aldehir@users.noreply.github.com);Assisted-by: Claude Opus 5.5
tests:修复 deferred tools 测试的类型检查。Assisted-by: Claude Opus 5.5
Website: https://llama.app
Attestations: https://github.com/ggml-org/llama.cpp/attestations/60626465
macOS/iOS:macOS Apple Silicon(arm64);macOS Apple Silicon(arm64,启用 KleidiAI)——已禁用;macOS Intel(x64);iOS XCFramework
Linux:Ubuntu x64(CPU);Ubuntu arm64(CPU);Ubuntu s390x(CPU);Ubuntu x64(Vulkan);Ubuntu arm64(Vulkan);Ubuntu x64(CUDA 12)——CUDA 12.8 库;Ubuntu x64(CUDA 13)——CUDA 13.4 库;Ubuntu arm64(CUDA 13)——CUDA 13.4 库;Ubuntu x64(ROCm 10.0);Ubuntu x64(OpenVINO);Ubuntu x64(SYCL FP32);Ubuntu x64(SYCL FP16);Linux arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Android:Android arm64(CPU);Android arm64(Snapdragon:CPU、Adreno GPU、Hexagon NPU)——设置指南
Windows:Windows x64(CPU);Windows arm64(CPU);Windows arm64(OpenCL Adreno);Windows x64(CUDA 12)——CUDA 12.4 DLL;Windows x64(CUDA 13)——CUDA 13.4 DLL;Windows arm64(CUDA 13)——CUDA 13.4 DLL;Windows x64(Vulkan);Windows arm64(Vulkan);Windows x64(OpenVINO);Windows x64(SYCL);Windows x64(ROCm 10.0)
openEuler:已禁用——openEuler x86(310p);openEuler x86(910b,ACL Graph);openEuler aarch64(310p);openEuler aarch64(910b,ACL Graph)
UI:UIx64UbuntuWindows阅读全文 ↗Hynix供给将持续超SK Hynix 预计到 2030 年需求都将持续超过供给Reddit 讨论:据 CNBC 报道(https://www.cnbc.com/2026/10/28/sk-hynix-third-quarter-profit.html),SK Hynix 预计到 2030 年内存需求都将持续超过供给。发帖人感叹:眼下已经离谱飙升的内存价格,未来几年回头看或许反倒像"捡了便宜"。SK Hynix 预计到 2030 年需求都将持续超过供给Reddit 讨论:据 CNBC 报道(https://www.cnbc.com/2026/10/28/sk-hynix-third-quarter-profit.html),SK Hynix 预计到 2030 年内存需求都将持续超过供给。发帖人感叹:眼下已经离谱飙升的内存价格,未来几年回头看或许反倒像"捡了便宜"。Hynix供给将持续超阅读全文 ↗
LiquidAIb11938llama.cppllama.cpp b11938:新增 LiquidAI LFM3-1.7B 与 LFM3-VL-2B 模型llama:新增 LiquidAI/LFM3-1.7B 与 LiquidAI/LFM3-VL-2B(#31252);tests:为 LFM3 测试模型设置 SWA rope base。llama.cpp b11938:新增 LiquidAI LFM3-1.7B 与 LFM3-VL-2B 模型llama:新增 LiquidAI/LFM3-1.7B 与 LiquidAI/LFM3-VL-2B(#31252);tests:为 LFM3 测试模型设置 SWA rope base。LiquidAIb11938llama.cpp阅读全文 ↗
llama.cpp b11938:新增 LiquidAI LFM3-1.7B 与 LFM3-VL-2B 模型llama:新增 LiquidAI/LFM3-1.7B 与 LiquidAI/LFM3-VL-2B(#31252);tests:为 LFM3 测试模型设置 SWA rope base。llama.cpp b11938:新增 LiquidAI LFM3-1.7B 与 LFM3-VL-2B 模型llama:新增 LiquidAI/LFM3-1.7B 与 LiquidAI/LFM3-VL-2B(#31252);tests:为 LFM3 测试模型设置 SWA rope base。LiquidAIb11938llama.cpp阅读全文 ↗一台本地云端合成榜单受够受够了云端合成榜单和小样本测试,我为 4B–35B 模型自建了一台本地 GPU 基准测试服务器大家好。每次看现有的 LLM 榜单,我都觉得缺一份实用数据:在买得起的本地硬件上跑量化开源权重模型的真实表现。大多数榜单只是照搬厂商云端分数,或者只跑基准的一小撮样本,而且没有一份榜单会告诉你,一个模型实际要坐在那里算多久才能跑完。受够了云端合成榜单和小样本测试,我为 4B–35B 模型自建了一台本地 GPU 基准测试服务器大家好。每次看现有的 LLM 榜单,我都觉得缺一份实用数据:在买得起的本地硬件上跑量化开源权重模型的真实表现。大多数榜单只是照搬厂商云端分数,或者只跑基准的一小撮样本,而且没有一份榜单会告诉你,一个模型实际要坐在那里算多久才能跑完。一台本地云端合成榜单受够阅读全文 ↗
LFM3-Audio-2B新音频模型Liquid 新音频模型:LFM3-Audio-2BLiquid AI 又一款好模型!适合边缘设备:LFM3-Audio-2B 是一款紧凑而功能完备的音频模型,可在笔记本和边缘设备上本地运行。它接受文本或音频输入,以文本、语音或两者兼有的方式回应。语音聊天:出声提问,即可获得文本与语音的流式回复。新音频模型:LFM3-Audio-2BLiquid AI 又一款好模型!适合边缘设备:LFM3-Audio-2B 是一款紧凑而功能完备的音频模型,可在笔记本和边缘设备上本地运行。它接受文本或音频输入,以文本、语音或两者兼有的方式回应。语音聊天:出声提问,即可获得文本与语音的流式回复。LFM3-Audio-2B新音频模型Liquid阅读全文 ↗
OpenAIagent个开源等价实现 OpenAI 近三个月的重大成果来自用 agent 蜂群扩展测试时算力——我照此思路做了个开源等价实现,欢迎试用我做测试时扩展(test-time scaling)已经有一段时间了,之前就在这个 sub 发过一些成果。最近我对核心系统设计做了大幅简化,终于觉得现在谁都能看懂它,并直接把它用在自己最难的问题上。OpenAI 近三个月的重大成果来自用 agent 蜂群扩展测试时算力——我照此思路做了个开源等价实现,欢迎试用我做测试时扩展(test-time scaling)已经有一段时间了,之前就在这个 sub 发过一些成果。最近我对核心系统设计做了大幅简化,终于觉得现在谁都能看懂它,并直接把它用在自己最难的问题上。OpenAIagent个开源等价实现阅读全文 ↗
万美元……为什么卖到Different 5090 现在为什么卖到 1 万美元……Reddit 讨论帖:RTX 5090 显卡如今为何卖到约 1 万美元(原摘要仅为「submitted by /u/Different_Fix_2217」模板尾巴,无实质内容;讨论焦点见标题)。5090 现在为什么卖到 1 万美元……Reddit 讨论帖:RTX 5090 显卡如今为何卖到约 1 万美元(原摘要仅为「submitted by /u/Different_Fix_2217」模板尾巴,无实质内容;讨论焦点见标题)。万美元……为什么卖到Different阅读全文 ↗
maskk-poolb11936llama.cpp b11936:k-pool 稀疏选择构建不再依赖 kq_mask 形状llama:k-pool 稀疏选择的构建不再依赖 kq_mask 形状(#31243)。qwen4exp(QSA)与 glm5-next 按索引挑选缓存单元,已不再读取 kq_mask 的取值,但选择本身仍沿用稠密 kq_mask 的形状来构造。llama.cpp b11936:k-pool 稀疏选择构建不再依赖 kq_mask 形状llama:k-pool 稀疏选择的构建不再依赖 kq_mask 形状(#31243)。qwen4exp(QSA)与 glm5-next 按索引挑选缓存单元,已不再读取 kq_mask 的取值,但选择本身仍沿用稠密 kq_mask 的形状来构造。maskk-poolb11936阅读全文 ↗
llama.cpp b11936:k-pool 稀疏选择构建不再依赖 kq_mask 形状llama:k-pool 稀疏选择的构建不再依赖 kq_mask 形状(#31243)。qwen4exp(QSA)与 glm5-next 按索引挑选缓存单元,已不再读取 kq_mask 的取值,但选择本身仍沿用稠密 kq_mask 的形状来构造。llama.cpp b11936:k-pool 稀疏选择构建不再依赖 kq_mask 形状llama:k-pool 稀疏选择的构建不再依赖 kq_mask 形状(#31243)。qwen4exp(QSA)与 glm5-next 按索引挑选缓存单元,已不再读取 kq_mask 的取值,但选择本身仍沿用稠密 kq_mask 的形状来构造。maskk-poolb11936阅读全文 ↗LFM3-Omni-2B-GGUFLiquidAIllama.cpp LiquidAI/LFM3-Omni-2B-GGUF讨论帖:楼主盛赞 LiquidAI 团队的 LFM3-Omni-2B-GGUF——tdakhran 迅速协调了 llama.cpp 与团队同步(零日!)发布对这一全模态(omni)模型的支持。楼主称这对自己是真正改变局面之作:这是首个真正支持波兰语 TTS 和 STT 的前沿实验室开源模型,且 2B 的紧凑体量让端侧部署切实可行。LiquidAI/LFM3-Omni-2B-GGUF讨论帖:楼主盛赞 LiquidAI 团队的 LFM3-Omni-2B-GGUF——tdakhran 迅速协调了 llama.cpp 与团队同步(零日!)发布对这一全模态(omni)模型的支持。楼主称这对自己是真正改变局面之作:这是首个真正支持波兰语 TTS 和 STT 的前沿实验室开源模型,且 2B 的紧凑体量让端侧部署切实可行。LFM3-Omni-2B-GGUFLiquidAIllama.cpp阅读全文 ↗
Qwen3.8无损统计意义 统计意义上无损的 Qwen3.8 27B GGUF转发帖:楼主仅贴出 Hugging Face 链接——作者把自己的分析藏在了博客付费墙之后;并调侃称,看来作者是想让 qwen3.8 FN 去 Substack 上找一个「漏洞」,把其博客内容上传到 Alibaba 服务器。统计意义上无损的 Qwen3.8 27B GGUF转发帖:楼主仅贴出 Hugging Face 链接——作者把自己的分析藏在了博客付费墙之后;并调侃称,看来作者是想让 qwen3.8 FN 去 Substack 上找一个「漏洞」,把其博客内容上传到 Alibaba 服务器。Qwen3.8无损统计意义阅读全文 ↗
WebGPU实现实时视频字幕本地运行 LFM3-VL-2B 在浏览器内经 WebGPU 本地运行,实现实时视频字幕分享帖:LFM3-VL-2B 在浏览器中经 WebGPU 本地运行,实现实时视频字幕生成。HF 模型合集:https://huggingface.co/collections/LiquidAI/lfm3 ;WebGPU 在线演示:https://huggingface.co/spaces/webml-community/LFM3-VL-2B-WebGPULFM3-VL-2B 在浏览器内经 WebGPU 本地运行,实现实时视频字幕分享帖:LFM3-VL-2B 在浏览器中经 WebGPU 本地运行,实现实时视频字幕生成。HF 模型合集:https://huggingface.co/collections/LiquidAI/lfm3 ;WebGPU 在线演示:https://huggingface.co/spaces/webml-community/LFM3-VL-2B-WebGPUWebGPU实现实时视频字幕本地运行阅读全文 ↗
OpenBMB发布另配 OpenBMB 发布 1.3B OCR 模型,另配 2B 模型检查其输出PDF 转成干净的 Markdown,不代表所有数字都完好地保住了。OpenBMB 刚刚发布 MiniCPM-OCR 1.0——一个用于解析中英文文档的 1.3B 模型,同时推出 MiniCPM-OCR Jev,一个用来检查 OCR 输出的 2B 模型。Jev 接收一张图像裁块及其对应的 OCR 结果,然后返回一个质量分。OpenBMB 发布 1.3B OCR 模型,另配 2B 模型检查其输出PDF 转成干净的 Markdown,不代表所有数字都完好地保住了。OpenBMB 刚刚发布 MiniCPM-OCR 1.0——一个用于解析中英文文档的 1.3B 模型,同时推出 MiniCPM-OCR Jev,一个用来检查 OCR 输出的 2B 模型。Jev 接收一张图像裁块及其对应的 OCR 结果,然后返回一个质量分。OpenBMB发布另配阅读全文 ↗
b11935errorlengthllama.cpp b11935:rpc 层捕获 recv_msg 中的 std::length_errorllama.cpp 发布 b11935,改动为 rpc 模块在 recv_msg 中捕获 std::length_error 异常(#31204);发布说明另附各平台构建产物清单与公证信息。llama.cpp b11935:rpc 层捕获 recv_msg 中的 std::length_errorllama.cpp 发布 b11935,改动为 rpc 模块在 recv_msg 中捕获 std::length_error 异常(#31204);发布说明另附各平台构建产物清单与公证信息。b11935errorlength阅读全文 ↗
llama.cpp b11935:rpc 层捕获 recv_msg 中的 std::length_errorllama.cpp 发布 b11935,改动为 rpc 模块在 recv_msg 中捕获 std::length_error 异常(#31204);发布说明另附各平台构建产物清单与公证信息。llama.cpp b11935:rpc 层捕获 recv_msg 中的 std::length_errorllama.cpp 发布 b11935,改动为 rpc 模块在 recv_msg 中捕获 std::length_error 异常(#31204);发布说明另附各平台构建产物清单与公证信息。b11935errorlength阅读全文 ↗构建专用多模态模型FoundationLiquid用 LFM3 构建专用多模态模型LFM3 是我们的新一代 Liquid Foundation Models(LFM),定位为专用智能的起点。它把文本、视觉、音频、omni 和决策模型放到同一个共享主干上,参数量都在 2B 级别。这意味着你可以为你的模态挑选模型,在自己的数据上微调用 LFM3 构建专用多模态模型LFM3 是我们的新一代 Liquid Foundation Models(LFM),定位为专用智能的起点。它把文本、视觉、音频、omni 和决策模型放到同一个共享主干上,参数量都在 2B 级别。这意味着你可以为你的模态挑选模型,在自己的数据上微调构建专用多模态模型FoundationLiquid阅读全文 ↗
AgentLiquidAI专用应用 LiquidAI 发布 LFM3-1.7B:面向本地 Agent 与专用应用的 1.7B 文本模型LiquidAI 推出基于全新 tri-hybrid 架构的 LFM3-1.7B 文本模型,面向本地 Agent 与专用应用:针对 Hermes Agent、Pi、OpenClaw 等 Agent 框架做过后训练,支持 256K tokens 上下文,4-bit 精度下仅需约 1 GB 内存;llama.cpp 支持已合并。LiquidAI 发布 LFM3-1.7B:面向本地 Agent 与专用应用的 1.7B 文本模型LiquidAI 推出基于全新 tri-hybrid 架构的 LFM3-1.7B 文本模型,面向本地 Agent 与专用应用:针对 Hermes Agent、Pi、OpenClaw 等 Agent 框架做过后训练,支持 256K tokens 上下文,4-bit 精度下仅需约 1 GB 内存;llama.cpp 支持已合并。AgentLiquidAI专用应用阅读全文 ↗
token本地Cursor 我是王,不过是「本地」王 😂讨论帖:楼主自嘲是个「本地土皇帝」——全天带两台 Strata 引擎、各跑 70tps,一天烧 1200 万 token,颇有王者之感;结果刷 Twitter 刷到一条帖子说 poteto 每分钟要用 3400 万 token。更新:网友好奇她是谁、拿这些 token 干什么——poteto 是其 Twitter 昵称,曾在 Cursor 工作直至 xAI 收购该公司,如今每月向 Cursor 和 GrokBot 交付 2500 个 PR。我是王,不过是「本地」王 😂讨论帖:楼主自嘲是个「本地土皇帝」——全天带两台 Strata 引擎、各跑 70tps,一天烧 1200 万 token,颇有王者之感;结果刷 Twitter 刷到一条帖子说 poteto 每分钟要用 3400 万 token。更新:网友好奇她是谁、拿这些 token 干什么——poteto 是其 Twitter 昵称,曾在 Cursor 工作直至 xAI 收购该公司,如今每月向 Cursor 和 GrokBot 交付 2500 个 PR。token本地Cursor阅读全文 ↗
取得模型真实文档解析 1.3B OCR 模型在真实文档解析上取得 93.68 分,OCR 错误迎来 AI 裁判多数 OCR 模型专注于读取文档,MiniCPM-OCR 增加了第二个环节:一个判断 OCR 结果是否真正可信的模型。OpenBMB 刚发布两个开源模型:MiniCPM-OCR 1.0(1.3B):在 Real5-OmniDocBench 上得 93.68 分,瞄准弯曲页面、手机照片、倾斜扫描等真实世界文档1.3B OCR 模型在真实文档解析上取得 93.68 分,OCR 错误迎来 AI 裁判多数 OCR 模型专注于读取文档,MiniCPM-OCR 增加了第二个环节:一个判断 OCR 结果是否真正可信的模型。OpenBMB 刚发布两个开源模型:MiniCPM-OCR 1.0(1.3B):在 Real5-OmniDocBench 上得 93.68 分,瞄准弯曲页面、手机照片、倾斜扫描等真实世界文档取得模型真实文档解析阅读全文 ↗
平台升级AliExpressAsrock 8 卡 R9700 平台升级晒机帖:楼主展示自己的 8 卡 R9700 平台——老款 Corsair 机箱,顶部架一个 AliExpress 廉价 GPU 支架。配置:Threadripper 9955WX、128GB DDR5 5600(256GB 太贵没上)、Asrock WRX90 WS EVO、Seasonic 2200W + 1600W 双电源、8x R9700,用 bifurcation 卡加 6 根延长线(遇到些问题,准备换 retimer)。从 4 卡升级到 8 卡,为将来更大的模型留余量。目前仍在跑 qfn;试过 GLM 5.3 Flash,但 QFN 配 radiance 的体验就是好。8 卡 R9700 平台升级晒机帖:楼主展示自己的 8 卡 R9700 平台——老款 Corsair 机箱,顶部架一个 AliExpress 廉价 GPU 支架。配置:Threadripper 9955WX、128GB DDR5 5600(256GB 太贵没上)、Asrock WRX90 WS EVO、Seasonic 2200W + 1600W 双电源、8x R9700,用 bifurcation 卡加 6 根延长线(遇到些问题,准备换 retimer)。从 4 卡升级到 8 卡,为将来更大的模型留余量。目前仍在跑 qfn;试过 GLM 5.3 Flash,但 QFN 配 radiance 的体验就是好。平台升级AliExpressAsrock阅读全文 ↗
10月27日27
b11934llama.cpp加速测试llama.cpp b11934:加速测试中的张量数据生成与模型保存本版集中优化测试工具链:save_models 只创建模型而不再构建多余的 llama_context,用 splitmix64 + Box-Muller 取代缓慢的 std::normal_distribution 抽样,并改为共享抽样池、增加保存体积日志;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11934:加速测试中的张量数据生成与模型保存本版集中优化测试工具链:save_models 只创建模型而不再构建多余的 llama_context,用 splitmix64 + Box-Muller 取代缓慢的 std::normal_distribution 抽样,并改为共享抽样池、增加保存体积日志;发布说明另附各平台构建产物清单与公证信息。b11934llama.cpp加速测试阅读全文 ↗
llama.cpp b11934:加速测试中的张量数据生成与模型保存本版集中优化测试工具链:save_models 只创建模型而不再构建多余的 llama_context,用 splitmix64 + Box-Muller 取代缓慢的 std::normal_distribution 抽样,并改为共享抽样池、增加保存体积日志;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11934:加速测试中的张量数据生成与模型保存本版集中优化测试工具链:save_models 只创建模型而不再构建多余的 llama_context,用 splitmix64 + Box-Muller 取代缓慢的 std::normal_distribution 抽样,并改为共享抽样池、增加保存体积日志;发布说明另附各平台构建产物清单与公证信息。b11934llama.cpp加速测试阅读全文 ↗Spark-X2.6-1.7B性能几乎版相当 Spark-X2.6-1.7B:性能几乎与 4B 版相当作者介绍 Spark-X2.6-1.7B:参数量不到自家 4B 模型的一半,两项基准成绩已相当接近——SWE Verified 为 59.8 对 62.8,τ²-bench 为 85.3 对 86.9,且两者均在 high thinking 模式下测得;欢迎到 Hugging Face 试用并点赞(https://huggingface.co/XHToken/Spark-X2.6-1.7B)。Spark-X2.6-1.7B:性能几乎与 4B 版相当作者介绍 Spark-X2.6-1.7B:参数量不到自家 4B 模型的一半,两项基准成绩已相当接近——SWE Verified 为 59.8 对 62.8,τ²-bench 为 85.3 对 86.9,且两者均在 high thinking 模式下测得;欢迎到 Hugging Face 试用并点赞(https://huggingface.co/XHToken/Spark-X2.6-1.7B)。Spark-X2.6-1.7B性能几乎版相当阅读全文 ↗
b11933dimllama.cppllama.cpp b11933:vulkan 修复 CI llvmpipe,允许 MUL_MAT 中 dim 3 广播(#31239)vulkan: fix CI llvmpipe by allowing dim 3 broadcast in MUL_MAT ( #31239 ) vulkan: allow dim 3 broadcast in MUL_MAT supports_op rejected every MUL_MAT whose src0 and src1 differ in…llama.cpp b11933:vulkan 修复 CI llvmpipe,允许 MUL_MAT 中 dim 3 广播(#31239)vulkan: fix CI llvmpipe by allowing dim 3 broadcast in MUL_MAT ( #31239 ) vulkan: allow dim 3 broadcast in MUL_MAT supports_op rejected every MUL_MAT whose src0 and src1 differ in…b11933dimllama.cpp阅读全文 ↗
llama.cpp b11933:vulkan 修复 CI llvmpipe,允许 MUL_MAT 中 dim 3 广播(#31239)vulkan: fix CI llvmpipe by allowing dim 3 broadcast in MUL_MAT ( #31239 ) vulkan: allow dim 3 broadcast in MUL_MAT supports_op rejected every MUL_MAT whose src0 and src1 differ in…llama.cpp b11933:vulkan 修复 CI llvmpipe,允许 MUL_MAT 中 dim 3 广播(#31239)vulkan: fix CI llvmpipe by allowing dim 3 broadcast in MUL_MAT ( #31239 ) vulkan: allow dim 3 broadcast in MUL_MAT supports_op rejected every MUL_MAT whose src0 and src1 differ in…b11933dimllama.cpp阅读全文 ↗SenseNovaCode2Video修改代码生成视频 SenseNova 6.8 Code2Video:通过编写和修改代码生成视频的开源模型想想大家在 Claude Opus 5.5 上做动画的流程:模型写代码,渲染工具把代码变成视频,再用后续指令修改结果。SenseNova 采用同样的大致思路,提供一个专注于视频创作的模型和创作 Skill。几个亮点:通过代码生成视频SenseNova 6.8 Code2Video:通过编写和修改代码生成视频的开源模型想想大家在 Claude Opus 5.5 上做动画的流程:模型写代码,渲染工具把代码变成视频,再用后续指令修改结果。SenseNova 采用同样的大致思路,提供一个专注于视频创作的模型和创作 Skill。几个亮点:通过代码生成视频SenseNovaCode2Video修改代码生成视频阅读全文 ↗
LocalLLaMAFlashMiMo r/LocalLLaMA 社区基准测试——GLM 5.3 Flash 对比 Hy 4 Preview 与 MiMo v2.6 Pro发帖者制作了一份基准测试,并把本版(r/LocalLLaMA)网友的评论纳入其中,作为一次观察模型实际体感的实验。r/LocalLLaMA 社区基准测试——GLM 5.3 Flash 对比 Hy 4 Preview 与 MiMo v2.6 Pro发帖者制作了一份基准测试,并把本版(r/LocalLLaMA)网友的评论纳入其中,作为一次观察模型实际体感的实验。LocalLLaMAFlashMiMo阅读全文 ↗
b11937llama.cppcmake llama.cpp b11937cmake:WASI 不支持创建(spawn)进程(#30751)llama.cpp b11937cmake:WASI 不支持创建(spawn)进程(#30751)b11937llama.cppcmake阅读全文 ↗
b11932llama.cppmtmd-clillama.cpp b11932 发布mtmd-cli:缩小 batch 指针的作用域( #31155 )( #31165 );mtmd-cli:缩小 batch 指针的作用域( #31155 );mtmd-cli:移除 CLI 回归测试。发布说明另附官网、公证信息与各平台构建产物清单。llama.cpp b11932 发布mtmd-cli:缩小 batch 指针的作用域( #31155 )( #31165 );mtmd-cli:缩小 batch 指针的作用域( #31155 );mtmd-cli:移除 CLI 回归测试。发布说明另附官网、公证信息与各平台构建产物清单。b11932llama.cppmtmd-cli阅读全文 ↗
llama.cpp b11932 发布mtmd-cli:缩小 batch 指针的作用域( #31155 )( #31165 );mtmd-cli:缩小 batch 指针的作用域( #31155 );mtmd-cli:移除 CLI 回归测试。发布说明另附官网、公证信息与各平台构建产物清单。llama.cpp b11932 发布mtmd-cli:缩小 batch 指针的作用域( #31155 )( #31165 );mtmd-cli:缩小 batch 指针的作用域( #31155 );mtmd-cli:移除 CLI 回归测试。发布说明另附官网、公证信息与各平台构建产物清单。b11932llama.cppmtmd-cli阅读全文 ↗serverb11930llama.cppllama.cpp b11930 发布:server 支持按设备内存余量动态卸载模型server:新增路由设备内存余量参数,支持动态卸载( #21231 )。server:新增 --models-memory-max 参数,当模型超过内存大小阈值时允许动态卸载;估算时计入待加载模型的大小;使用 no_alloc 仅获取模型加载所需内存;设置模型……llama.cpp b11930 发布:server 支持按设备内存余量动态卸载模型server:新增路由设备内存余量参数,支持动态卸载( #21231 )。server:新增 --models-memory-max 参数,当模型超过内存大小阈值时允许动态卸载;估算时计入待加载模型的大小;使用 no_alloc 仅获取模型加载所需内存;设置模型……serverb11930llama.cpp阅读全文 ↗
llama.cpp b11930 发布:server 支持按设备内存余量动态卸载模型server:新增路由设备内存余量参数,支持动态卸载( #21231 )。server:新增 --models-memory-max 参数,当模型超过内存大小阈值时允许动态卸载;估算时计入待加载模型的大小;使用 no_alloc 仅获取模型加载所需内存;设置模型……llama.cpp b11930 发布:server 支持按设备内存余量动态卸载模型server:新增路由设备内存余量参数,支持动态卸载( #21231 )。server:新增 --models-memory-max 参数,当模型超过内存大小阈值时允许动态卸载;估算时计入待加载模型的大小;使用 no_alloc 仅获取模型加载所需内存;设置模型……serverb11930llama.cpp阅读全文 ↗OperaWebAI将本地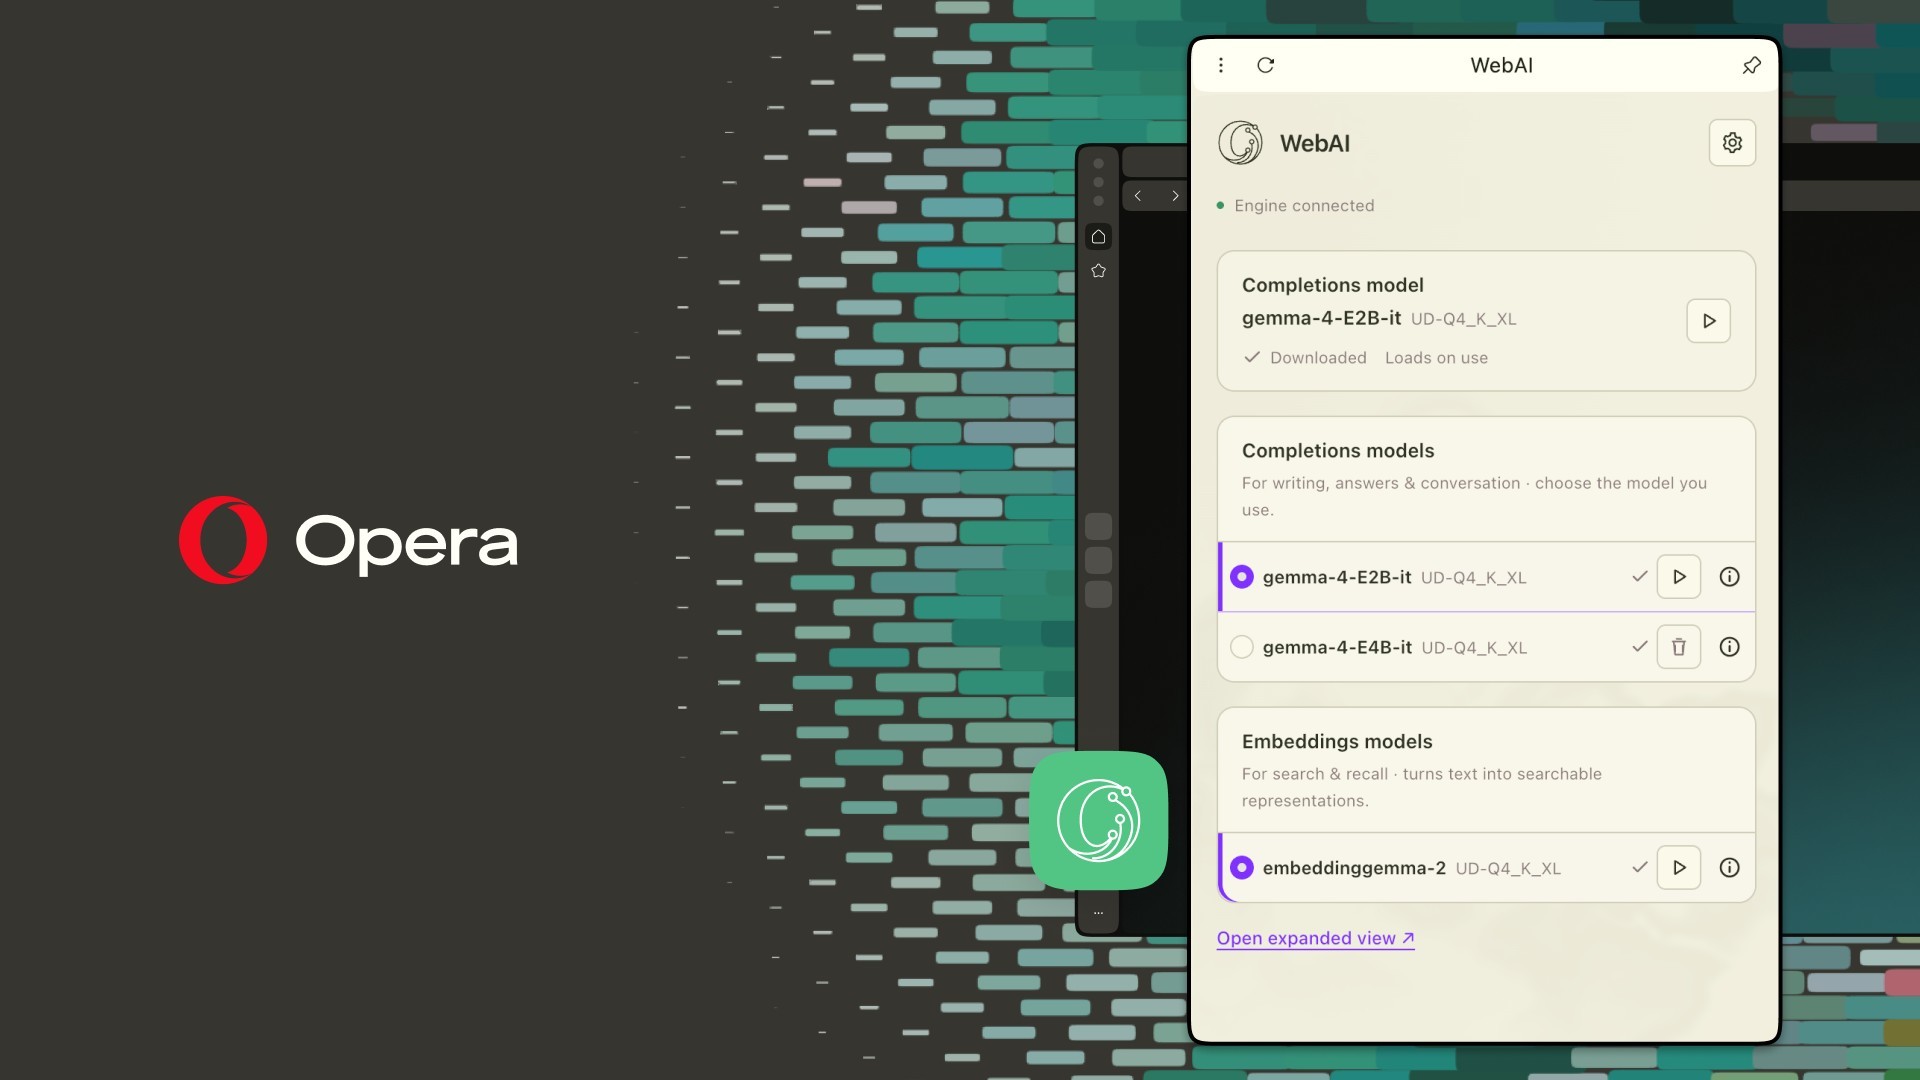 Opera 推出 WebAI,将本地 AI 模型引入旗下浏览器Opera 于 2026 年 10 月 27 日宣布,开始在其浏览器中直接内置本地 AI 模型,让运行在用户自己电脑上的 AI 成为下一代 Opera 浏览器的核心组成部分。首批功能以可选加入的早期预览形式登陆 Opera One,Opera GX 和 Opera Neon 随后将跟进。Opera 推出 WebAI,将本地 AI 模型引入旗下浏览器Opera 于 2026 年 10 月 27 日宣布,开始在其浏览器中直接内置本地 AI 模型,让运行在用户自己电脑上的 AI 成为下一代 Opera 浏览器的核心组成部分。首批功能以可选加入的早期预览形式登陆 Opera One,Opera GX 和 Opera Neon 随后将跟进。OperaWebAI将本地阅读全文 ↗
Qwen3.8-27Bagentllama-server 单张 RTX 3090 跑 4 个编码 agent:自研 CUDA 引擎驱动 Qwen3.8-27B,合计约 290 tok/s(为 llama-server --parallel 的 3-4 倍)我一直在开发 OpenJet,一个为 Qwen3.8-27B Q4_K_M 配备自研 CUDA megakernel 引擎的本地编码 agent。此前它一次只服务一个会话,新版本可以在单张 GPU 上同时服务多个 agent。 https://reddit.com/link/1xgs8hp/video/p0zd2rxse0yh1/player 数据(RTX 3090,Qwen3.8-27B Q4_K_M ):单张 RTX 3090 跑 4 个编码 agent:自研 CUDA 引擎驱动 Qwen3.8-27B,合计约 290 tok/s(为 llama-server --parallel 的 3-4 倍)我一直在开发 OpenJet,一个为 Qwen3.8-27B Q4_K_M 配备自研 CUDA megakernel 引擎的本地编码 agent。此前它一次只服务一个会话,新版本可以在单张 GPU 上同时服务多个 agent。 https://reddit.com/link/1xgs8hp/video/p0zd2rxse0yh1/player 数据(RTX 3090,Qwen3.8-27B Q4_K_M ):Qwen3.8-27Bagentllama-server阅读全文 ↗
b11929llama.cpp发布llama.cpp b11929 发布:强制要求 --model 或 -hfcommon:必须提供 --model 或 -hf( #31242 ),由 Codex 协助。发布说明另附公证信息与各平台构建产物清单。llama.cpp b11929 发布:强制要求 --model 或 -hfcommon:必须提供 --model 或 -hf( #31242 ),由 Codex 协助。发布说明另附公证信息与各平台构建产物清单。b11929llama.cpp发布阅读全文 ↗
llama.cpp b11929 发布:强制要求 --model 或 -hfcommon:必须提供 --model 或 -hf( #31242 ),由 Codex 协助。发布说明另附公证信息与各平台构建产物清单。llama.cpp b11929 发布:强制要求 --model 或 -hfcommon:必须提供 --model 或 -hf( #31242 ),由 Codex 协助。发布说明另附公证信息与各平台构建产物清单。b11929llama.cpp发布阅读全文 ↗Ling-3.1-flash-1019base权重已发布 Ling-3.1-flash-1019 权重已发布,base 模型一并放出所谓"即将推出",结果只用了五天。上周我发过上一条公告。1019 权重现已上架 Hugging Face 。依然是总参数 560B、激活 25B,上下文窗口 1M。这就是他们在 AA Intelligence Index v4.3.2 上从 41 升到 44 的那次更新。据发布说明,AutomationBench-AA 从 62% 升至 68%……Ling-3.1-flash-1019 权重已发布,base 模型一并放出所谓"即将推出",结果只用了五天。上周我发过上一条公告。1019 权重现已上架 Hugging Face 。依然是总参数 560B、激活 25B,上下文窗口 1M。这就是他们在 AA Intelligence Index v4.3.2 上从 41 升到 44 的那次更新。据发布说明,AutomationBench-AA 从 62% 升至 68%……Ling-3.1-flash-1019base权重已发布阅读全文 ↗
MiniCPM-OCR-Jevb11928llama.cppllama.cpp b11928 新增 MiniCPM-OCR-Jev 模型支持(#30980)model:新增 MiniCPM-OCR-Jev( #30980 )。model:新增 MiniCPM-OCR-Jev 支持。该模型是 Qwen3.5-VL 主干,在最后一个 token 处读取价值头:它对 OCR 文本与其渲染出的图像打分,不生成内容。新增 openbmb-minicpm-ocr-jev 决策类型,由 POST /v1/systemone 提供服务。类别分数……llama.cpp b11928 新增 MiniCPM-OCR-Jev 模型支持(#30980)model:新增 MiniCPM-OCR-Jev( #30980 )。model:新增 MiniCPM-OCR-Jev 支持。该模型是 Qwen3.5-VL 主干,在最后一个 token 处读取价值头:它对 OCR 文本与其渲染出的图像打分,不生成内容。新增 openbmb-minicpm-ocr-jev 决策类型,由 POST /v1/systemone 提供服务。类别分数……MiniCPM-OCR-Jevb11928llama.cpp阅读全文 ↗
llama.cpp b11928 新增 MiniCPM-OCR-Jev 模型支持(#30980)model:新增 MiniCPM-OCR-Jev( #30980 )。model:新增 MiniCPM-OCR-Jev 支持。该模型是 Qwen3.5-VL 主干,在最后一个 token 处读取价值头:它对 OCR 文本与其渲染出的图像打分,不生成内容。新增 openbmb-minicpm-ocr-jev 决策类型,由 POST /v1/systemone 提供服务。类别分数……llama.cpp b11928 新增 MiniCPM-OCR-Jev 模型支持(#30980)model:新增 MiniCPM-OCR-Jev( #30980 )。model:新增 MiniCPM-OCR-Jev 支持。该模型是 Qwen3.5-VL 主干,在最后一个 token 处读取价值头:它对 OCR 文本与其渲染出的图像打分,不生成内容。新增 openbmb-minicpm-ocr-jev 决策类型,由 POST /v1/systemone 提供服务。类别分数……MiniCPM-OCR-Jevb11928llama.cpp阅读全文 ↗Qwen硬件搭配思路BubblinaR9700、RTX 3060 与 RTX 3090 跑 Qwen:硬件搭配思路大家觉得我的硬件怎样搭配最好?迷你主机(Bubblina):oculink eGPU 接 R9700(32GB AMD)、64GB DDR5 —— 跑 Qwen3.8-27B Paiton-KV4-vision,262K 上下文,8 路并发。台式机(BM1):Ryzen 5700G,目前是 RTX3060 12GB 加 GTX1660 6GB,64GB DDR4 —— 跑 Strata IQ2_XS,解锁 GPU 后速度出乎意料地快,但我不太敢……R9700、RTX 3060 与 RTX 3090 跑 Qwen:硬件搭配思路大家觉得我的硬件怎样搭配最好?迷你主机(Bubblina):oculink eGPU 接 R9700(32GB AMD)、64GB DDR5 —— 跑 Qwen3.8-27B Paiton-KV4-vision,262K 上下文,8 路并发。台式机(BM1):Ryzen 5700G,目前是 RTX3060 12GB 加 GTX1660 6GB,64GB DDR4 —— 跑 Strata IQ2_XS,解锁 GPU 后速度出乎意料地快,但我不太敢……Qwen硬件搭配思路Bubblina阅读全文 ↗
bpwISTA-DASLabDeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUFISTA-DASLab DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF 2.25bpw 与官方 API 对比我跑 ISTA-DASLab 的 DSv4.1-1017 2.25bpw 量化版已有几天,它表现稳健。不过平均只有 2.25bpw 这一点让我好奇,这个量化版跟完整模型相比究竟如何。本地环境:Project-maya v1.1.27,ISTA-DASLab 的 2.25bpw 量化版。与质量相关的设置:"DS4_IND……ISTA-DASLab DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF 2.25bpw 与官方 API 对比我跑 ISTA-DASLab 的 DSv4.1-1017 2.25bpw 量化版已有几天,它表现稳健。不过平均只有 2.25bpw 这一点让我好奇,这个量化版跟完整模型相比究竟如何。本地环境:Project-maya v1.1.27,ISTA-DASLab 的 2.25bpw 量化版。与质量相关的设置:"DS4_IND……bpwISTA-DASLabDeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF阅读全文 ↗
Ling-3.1-flash-1019inclusionAIFace inclusionAI/Ling-3.1-flash-1019(Hugging Face 模型卡)来自 inclusionAI:我们推出 Ling-3.1-flash-1019 ,即 Ling-3.1-flash 的升级版,总参数 560B、每 token 激活 25B、上下文窗口 100 万 token 。经过进一步的后训练优化,Ling-3.1-flash-1019 在推理和真实世界 agentic 能力上有显著提升……inclusionAI/Ling-3.1-flash-1019(Hugging Face 模型卡)来自 inclusionAI:我们推出 Ling-3.1-flash-1019 ,即 Ling-3.1-flash 的升级版,总参数 560B、每 token 激活 25B、上下文窗口 100 万 token 。经过进一步的后训练优化,Ling-3.1-flash-1019 在推理和真实世界 agentic 能力上有显著提升……Ling-3.1-flash-1019inclusionAIFace阅读全文 ↗
Metalb11927llama.cppllama.cpp b11927:Metal 后端新增 GGML_OP_TOP_K_MASK把 CUDA 后端的融合 top-k mask 移植到 Metal:grid-stride kernel 先以 -inf 填充输出,再由每行一个 threadgroup 覆写保留单元格的 mask 值;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11927:Metal 后端新增 GGML_OP_TOP_K_MASK把 CUDA 后端的融合 top-k mask 移植到 Metal:grid-stride kernel 先以 -inf 填充输出,再由每行一个 threadgroup 覆写保留单元格的 mask 值;发布说明另附各平台构建产物清单与公证信息。Metalb11927llama.cpp阅读全文 ↗
llama.cpp b11927:Metal 后端新增 GGML_OP_TOP_K_MASK把 CUDA 后端的融合 top-k mask 移植到 Metal:grid-stride kernel 先以 -inf 填充输出,再由每行一个 threadgroup 覆写保留单元格的 mask 值;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11927:Metal 后端新增 GGML_OP_TOP_K_MASK把 CUDA 后端的融合 top-k mask 移植到 Metal:grid-stride kernel 先以 -inf 填充输出,再由每行一个 threadgroup 覆写保留单元格的 mask 值;发布说明另附各平台构建产物清单与公证信息。Metalb11927llama.cpp阅读全文 ↗draftdflash2低量化在 dflash2 中使用 Q38FN?试试更低量化的 draft 模型楼主分享实测经验:听说 Qwen 3.8 27B 时代 Q4 量化 draft 模型的接受率与 Q8 及以上大致相当,于是让智能体分别制作了 F16、Q8、Q4 三个 Q38FN draft 模型,结果 Q4 带来的加速最明显。提醒大家:用 Q38FN 跑 dflash2(楼主配置为 strata)时,值得尝试更低量化的 draft 模型。在 dflash2 中使用 Q38FN?试试更低量化的 draft 模型楼主分享实测经验:听说 Qwen 3.8 27B 时代 Q4 量化 draft 模型的接受率与 Q8 及以上大致相当,于是让智能体分别制作了 F16、Q8、Q4 三个 Q38FN draft 模型,结果 Q4 带来的加速最明显。提醒大家:用 Q38FN 跑 dflash2(楼主配置为 strata)时,值得尝试更低量化的 draft 模型。draftdflash2低量化阅读全文 ↗
maskglm5-nextb11926llama.cpp b11926:glm5-next 的 QSA 不再依赖 kq_mask(含 DSA)glm5-next 让 QSA 不再依赖 kq_mask,并同步调整 DSA top-k mask,已在 DeepSeek-V3.2 的第 0、3 层上完成测试;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11926:glm5-next 的 QSA 不再依赖 kq_mask(含 DSA)glm5-next 让 QSA 不再依赖 kq_mask,并同步调整 DSA top-k mask,已在 DeepSeek-V3.2 的第 0、3 层上完成测试;发布说明另附各平台构建产物清单与公证信息。maskglm5-nextb11926阅读全文 ↗
llama.cpp b11926:glm5-next 的 QSA 不再依赖 kq_mask(含 DSA)glm5-next 让 QSA 不再依赖 kq_mask,并同步调整 DSA top-k mask,已在 DeepSeek-V3.2 的第 0、3 层上完成测试;发布说明另附各平台构建产物清单与公证信息。llama.cpp b11926:glm5-next 的 QSA 不再依赖 kq_mask(含 DSA)glm5-next 让 QSA 不再依赖 kq_mask,并同步调整 DSA top-k mask,已在 DeepSeek-V3.2 的第 0、3 层上完成测试;发布说明另附各平台构建产物清单与公证信息。maskglm5-nextb11926阅读全文 ↗Qwen3.5-9BDeepSeek工程二进制文件 让 DeepSeek 指挥四个 Qwen3.5-9B:用小型开源模型逆向工程二进制文件「Reverse Engineer Anything」近期爆火,但亮眼成果全靠闭源前沿模型;本实验让 DeepSeek-V4.1-Flash 出任 lead、四个 Qwen3.5-9B 担任 worker,由 oracle(diff_test)用约 600 个用例把关,验证小型本地模型组织起来做二进制逆向的可行性与成本。让 DeepSeek 指挥四个 Qwen3.5-9B:用小型开源模型逆向工程二进制文件「Reverse Engineer Anything」近期爆火,但亮眼成果全靠闭源前沿模型;本实验让 DeepSeek-V4.1-Flash 出任 lead、四个 Qwen3.5-9B 担任 worker,由 oracle(diff_test)用约 600 个用例把关,验证小型本地模型组织起来做二进制逆向的可行性与成本。Qwen3.5-9BDeepSeek工程二进制文件阅读全文 ↗
AlibabaCohereFlash驳斥 Cohere 关于 Qwen 3.8 Flash Next 向 Alibaba 远程 URL 上传数据的说法楼主逐条拆解 CohereLabs 公布的调查 traces:复现脚本预填充 2,232 个 token、恰好停在 URL 生成之前,等于强迫 Q38FN 充当 URL 生成器;所用检测提示词零上下文、无指令、歧义严重,近乎诱导幻觉;Cohere CEO 自己也承认该行为出现于不到十万分之一的调用、且并无蓄意证据。楼主 grep 了自启用首日以来的全部聊天日志,未发现任何 Alibaba URL;并指出若是 Claude、OpenAI 这类闭源模型,根本无从复现检验。结论:不放心可停用 Q38FN 或给 URL 加沙箱,但更应先弄清实验全过程再下判断。驳斥 Cohere 关于 Qwen 3.8 Flash Next 向 Alibaba 远程 URL 上传数据的说法楼主逐条拆解 CohereLabs 公布的调查 traces:复现脚本预填充 2,232 个 token、恰好停在 URL 生成之前,等于强迫 Q38FN 充当 URL 生成器;所用检测提示词零上下文、无指令、歧义严重,近乎诱导幻觉;Cohere CEO 自己也承认该行为出现于不到十万分之一的调用、且并无蓄意证据。楼主 grep 了自启用首日以来的全部聊天日志,未发现任何 Alibaba URL;并指出若是 Claude、OpenAI 这类闭源模型,根本无从复现检验。结论:不放心可停用 Q38FN 或给 URL 加沙箱,但更应先弄清实验全过程再下判断。AlibabaCohereFlash阅读全文 ↗
PCIeSplitTensor PCIe 3.0 x1 上跑 Tensor Split:实测效果不错加第二块 GPU 时不少人警告 PCIe 3.0 x1 会是巨大瓶颈;实测即便一块 RTX 3060 只挂在 x1 上,llama.cpp 从 layer split 改为 tensor split 后生成速度仍提升 42%,解码期间每卡双向流量仅约 90–110 MB/s,远低于 x1 单向约 985 MB/s 的理论上限,但提示词处理确实存在 37–41% 的 tensor split 惩罚。PCIe 3.0 x1 上跑 Tensor Split:实测效果不错加第二块 GPU 时不少人警告 PCIe 3.0 x1 会是巨大瓶颈;实测即便一块 RTX 3060 只挂在 x1 上,llama.cpp 从 layer split 改为 tensor split 后生成速度仍提升 42%,解码期间每卡双向流量仅约 90–110 MB/s,远低于 x1 单向约 985 MB/s 的理论上限,但提示词处理确实存在 37–41% 的 tensor split 惩罚。PCIeSplitTensor阅读全文 ↗
llama.cppGitHubPumpkin 为女朋友打造的 llama.cpp 图形化管理工具 Pumpkin:效果不错,已放上 GitHub女友因隐私需求要用本地模型但完全不会用终端,作者为此做了一个一体化图形管理器:自动检测硬件、下载合适的 llama.cpp 构建并挑选适配 GPU 与内存的量化,约 5 分钟即可跑起来;还能识别 LM Studio 与 Ollama 的既有模型,附带联网搜索、工具、MCP、skills、编码 Agent、文生图与手机端使用。为女朋友打造的 llama.cpp 图形化管理工具 Pumpkin:效果不错,已放上 GitHub女友因隐私需求要用本地模型但完全不会用终端,作者为此做了一个一体化图形管理器:自动检测硬件、下载合适的 llama.cpp 构建并挑选适配 GPU 与内存的量化,约 5 分钟即可跑起来;还能识别 LM Studio 与 Ollama 的既有模型,附带联网搜索、工具、MCP、skills、编码 Agent、文生图与手机端使用。llama.cppGitHubPumpkin阅读全文 ↗
FaceHuggingUnlimited-OCR-2 baidu/Unlimited-OCR-2 · Hugging Face 模型仓库发布【2026/10/27】🚀 Baidu 发布 Unlimited OCR 2,借助 SR-SWA 实现无限视野文档解析。要点:1)稀疏参考滑动窗口注意力(SR-SWA):将超长序列中的文本-视觉注意力交互压缩为一组固定规模的工作参考集(如 512 个 token),从而为计算复杂度设定上限——无论文档多长,每步解码延迟与内存占用均近乎恒定;2)从长视野走向无限视野解析:在 SR-SWA 驱动下,Unlimited OCR 2 在有限上下文窗口内实现真正无界的文档解析,随文档增长消除了二次方注意力扩展与内存瓶颈;3)超长文档解析 SOTA:在数十页级基准(如 MPDocBench)与极端百页级基准(如 MarathonDocBench)上均取得最先进性能。baidu/Unlimited-OCR-2 · Hugging Face 模型仓库发布【2026/10/27】🚀 Baidu 发布 Unlimited OCR 2,借助 SR-SWA 实现无限视野文档解析。要点:1)稀疏参考滑动窗口注意力(SR-SWA):将超长序列中的文本-视觉注意力交互压缩为一组固定规模的工作参考集(如 512 个 token),从而为计算复杂度设定上限——无论文档多长,每步解码延迟与内存占用均近乎恒定;2)从长视野走向无限视野解析:在 SR-SWA 驱动下,Unlimited OCR 2 在有限上下文窗口内实现真正无界的文档解析,随文档增长消除了二次方注意力扩展与内存瓶颈;3)超长文档解析 SOTA:在数十页级基准(如 MPDocBench)与极端百页级基准(如 MarathonDocBench)上均取得最先进性能。FaceHuggingUnlimited-OCR-2阅读全文 ↗
ggmlMetalb11923llama.cpp b11923ggml:放宽 scale 算子以支持非连续视图(#31146)。此前 SCALE 要求 src0 为一维连续,现放宽为仅需第 0 维连续、允许任意行步长(ggml_is_contiguous_rows),与 Metal 后端一元算子处理方式一致;涉及 ggml 放宽 ggml_scale_impl 断言、CPU 按字节步长寻址 src0 各行(f32/bf16)、CUDA 步长感知内核与 fastdiv 行分解、Metal 支持 bf16 scale,SYCL 维持连续性门槛。另有 CUDA 侧改动:非连续视图上跳过 softcap 融合,此类计算图暂留步长内核。已在 CPU、Metal 和 CUDA 上验证。llama.cpp b11923ggml:放宽 scale 算子以支持非连续视图(#31146)。此前 SCALE 要求 src0 为一维连续,现放宽为仅需第 0 维连续、允许任意行步长(ggml_is_contiguous_rows),与 Metal 后端一元算子处理方式一致;涉及 ggml 放宽 ggml_scale_impl 断言、CPU 按字节步长寻址 src0 各行(f32/bf16)、CUDA 步长感知内核与 fastdiv 行分解、Metal 支持 bf16 scale,SYCL 维持连续性门槛。另有 CUDA 侧改动:非连续视图上跳过 softcap 融合,此类计算图暂留步长内核。已在 CPU、Metal 和 CUDA 上验证。ggmlMetalb11923阅读全文 ↗
llama.cpp b11923ggml:放宽 scale 算子以支持非连续视图(#31146)。此前 SCALE 要求 src0 为一维连续,现放宽为仅需第 0 维连续、允许任意行步长(ggml_is_contiguous_rows),与 Metal 后端一元算子处理方式一致;涉及 ggml 放宽 ggml_scale_impl 断言、CPU 按字节步长寻址 src0 各行(f32/bf16)、CUDA 步长感知内核与 fastdiv 行分解、Metal 支持 bf16 scale,SYCL 维持连续性门槛。另有 CUDA 侧改动:非连续视图上跳过 softcap 融合,此类计算图暂留步长内核。已在 CPU、Metal 和 CUDA 上验证。llama.cpp b11923ggml:放宽 scale 算子以支持非连续视图(#31146)。此前 SCALE 要求 src0 为一维连续,现放宽为仅需第 0 维连续、允许任意行步长(ggml_is_contiguous_rows),与 Metal 后端一元算子处理方式一致;涉及 ggml 放宽 ggml_scale_impl 断言、CPU 按字节步长寻址 src0 各行(f32/bf16)、CUDA 步长感知内核与 fastdiv 行分解、Metal 支持 bf16 scale,SYCL 维持连续性门槛。另有 CUDA 侧改动:非连续视图上跳过 softcap 融合,此类计算图暂留步长内核。已在 CPU、Metal 和 CUDA 上验证。ggmlMetalb11923阅读全文 ↗b11925llama.cppROCm llama.cpp b11925ci:ROCm 发布构建改用 ccache 的 depend 模式(#31231)llama.cpp b11925ci:ROCm 发布构建改用 ccache 的 depend 模式(#31231)b11925llama.cppROCm阅读全文 ↗
llama.cppb11921padllama.cpp b11921llama:移除 memory 实例中已废弃的 n_pad(#31200)——所有调用方传入的 n_pad 均为 1,仅有的两处使用也都将其钳制为 256,故删除该参数、相关成员以及恒为真的 kv_size 断言。协助:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook,M5 Max,128GB)。文末为 llama.cpp 发布模板的构建平台矩阵(macOS/iOS、Linux、Android、Windows、openEuler 各构建目标清单)与网站/Attestations 链接,正文已照全译。llama.cpp b11921llama:移除 memory 实例中已废弃的 n_pad(#31200)——所有调用方传入的 n_pad 均为 1,仅有的两处使用也都将其钳制为 256,故删除该参数、相关成员以及恒为真的 kv_size 断言。协助:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook,M5 Max,128GB)。文末为 llama.cpp 发布模板的构建平台矩阵(macOS/iOS、Linux、Android、Windows、openEuler 各构建目标清单)与网站/Attestations 链接,正文已照全译。llama.cppb11921pad阅读全文 ↗
llama.cpp b11921llama:移除 memory 实例中已废弃的 n_pad(#31200)——所有调用方传入的 n_pad 均为 1,仅有的两处使用也都将其钳制为 256,故删除该参数、相关成员以及恒为真的 kv_size 断言。协助:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook,M5 Max,128GB)。文末为 llama.cpp 发布模板的构建平台矩阵(macOS/iOS、Linux、Android、Windows、openEuler 各构建目标清单)与网站/Attestations 链接,正文已照全译。llama.cpp b11921llama:移除 memory 实例中已废弃的 n_pad(#31200)——所有调用方传入的 n_pad 均为 1,仅有的两处使用也都将其钳制为 256,故删除该参数、相关成员以及恒为真的 kv_size 断言。协助:dsh:llama.cpp/ggml-org/Qwen3.8-Flash-Next-GGUF(MacBook,M5 Max,128GB)。文末为 llama.cpp 发布模板的构建平台矩阵(macOS/iOS、Linux、Android、Windows、openEuler 各构建目标清单)与网站/Attestations 链接,正文已照全译。llama.cppb11921pad阅读全文 ↗